Google о PDF в поиске: что поменять на сайте
13 октября 2026 года Google в подкасте Search Off the Record объяснил, как поиск читает PDF: превращает в HTML, ранжирует и может показать в ИИ-ответах. Для владельца сайта это повод проверить прайсы, меню и каталоги: сканы поиску не видны, а старые файлы живут в выдаче дольше страниц.
Источник: Google Search Off the Record
Что случилось
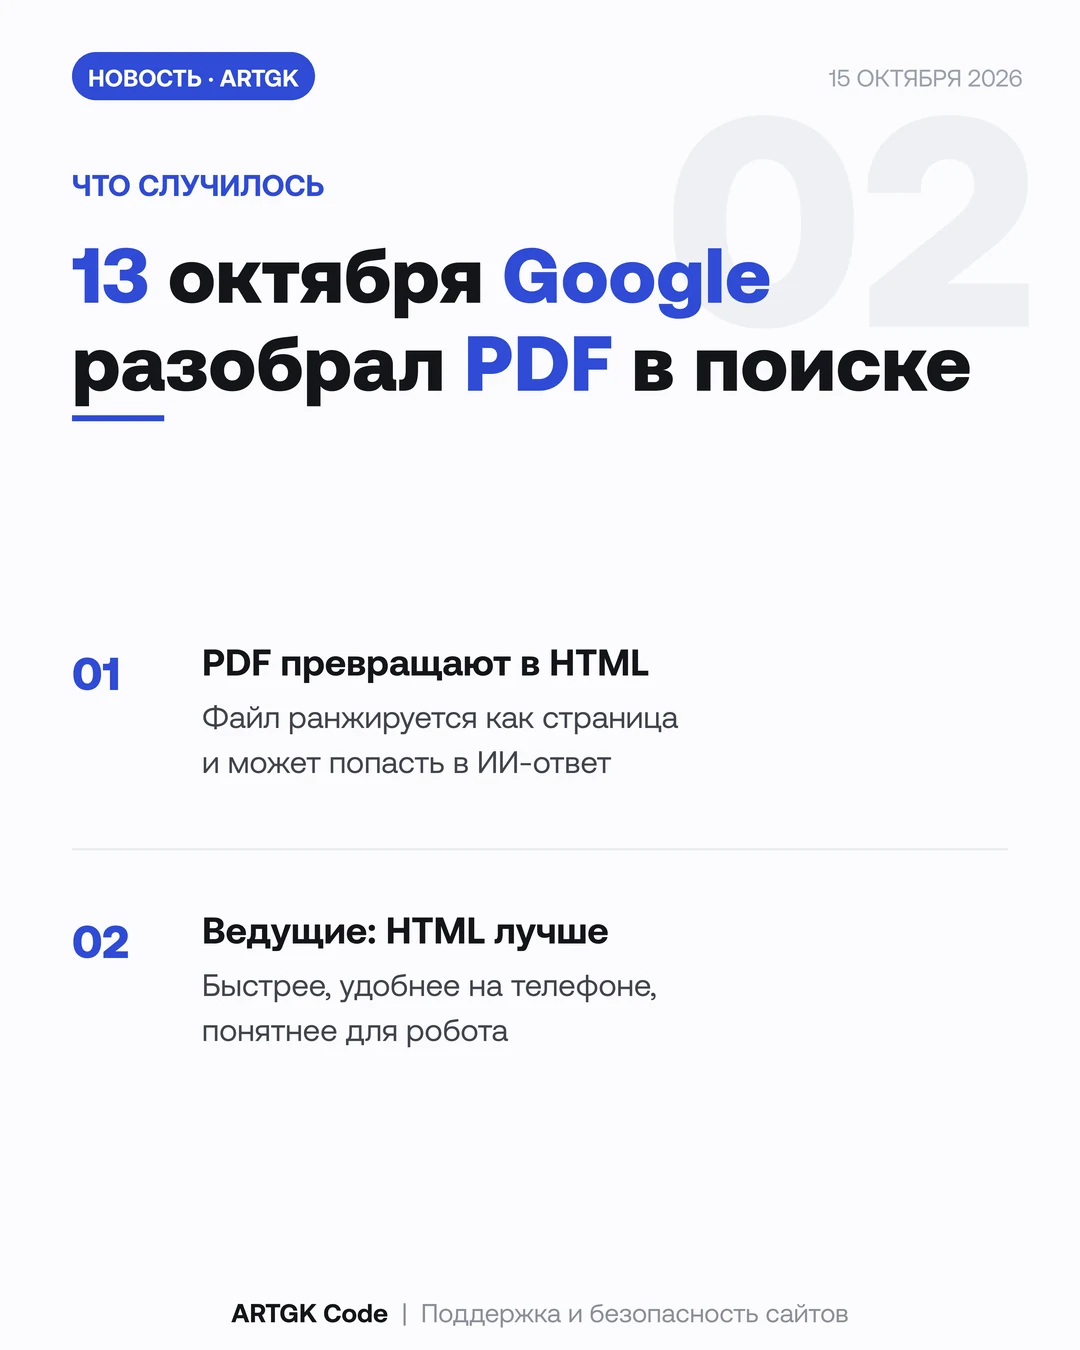
13 октября 2026 года команда Google Search Relations выпустила выпуск подкаста Search Off the Record «PDFs in Search: Indexing, AI & Pitfalls». Martin Splitt и John Mueller разбирают, как поиск обращается с PDF-файлами: как их читает, как ранжирует и где владельцы сайтов ломают себе индексацию.
Громких запретов нет. Но на сайтах малого бизнеса PDF лежат везде: прайс, меню, каталог, договор-оферта. Именно такие файлы чаще всего и теряются в поиске.
Как Google читает PDF
Конвейер индексации превращает текст PDF в HTML-представление. После этого файл попадает в те же системы, что и обычная страница. Из этого в подкасте и в пересказе Search Engine Roundtable следуют четыре вещи:
- PDF ранжируется обычным образом и может появляться в ответах ИИ-функций поиска, включая AI Overviews.
- Текстовые ссылки внутри PDF сканируются как обычные.
- У картинок внутри PDF нет собственных адресов, поэтому в поиск по картинкам они, как правило, не попадают.
- Google ставит лимиты на размер файла и для HTML, и для PDF. Точную границу для PDF в подкасте не называют, потому что пороги меняются. Цифры из старых материалов сверяйте с документацией.
Факты из выпуска
- Позиция ведущих: «HTML предпочтительнее, а PDF работают». Причины: мобильная вёрстка, перестройка текста при увеличении, скорость загрузки.
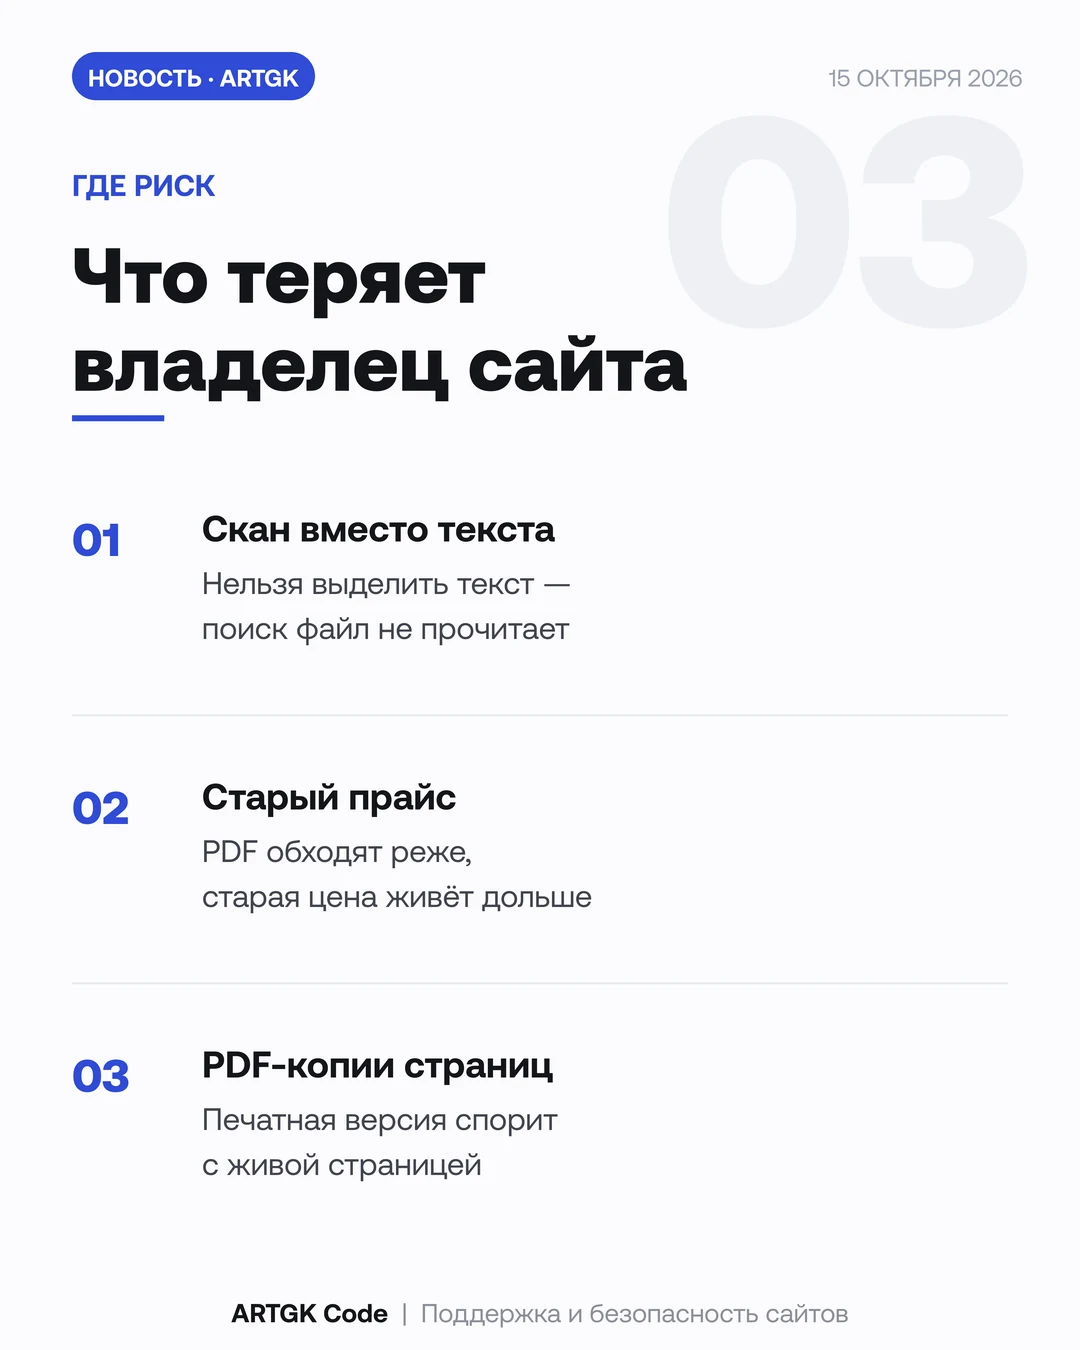
- Проверка на сканы: если из PDF нельзя выделить и скопировать текст, это, скорее всего, картинка. Google не сможет достать из неё текст, а экранные читалки не прочитают его вслух.
- Один и тот же файл на разных сайтах мешает выбору основной версии. Помогают HTTP-заголовок rel="canonical", заполненные метаданные и заметная ссылка на ваш сайт внутри документа.
- Файл llms.txt в виде PDF сохранять не стоит, даже если вы сторонник этого формата. Его оставляют обычным текстом.
- Пример про ресторан: PDF-меню лучше, чем никакого. Но адаптивная HTML-страница лучше по скорости, доступности и удобству.
- Из пересказа Search Engine Roundtable: PDF с паролем поисковые роботы не читают. PDF считается статичным файлом, его обходят реже, чем HTML. Чтобы обновлённый файл попал в индекс быстрее, выкладывайте его под новым адресом или с новым именем.
Что это значит для бизнеса
Первое: прайс и каталог в PDF живут отдельной жизнью от страницы услуги. Клиент, который пришёл из поиска на PDF, не видит меню сайта, формы заявки и кнопки «Купить». Он прочитал цену и ушёл.
Второе: устаревший PDF опаснее устаревшей страницы. Его обходят реже, значит старая цена может висеть в выдаче и в ответе нейросети дольше, чем вам кажется.
Третье: автоматические «версии для печати» в PDF. Выпуск прямо называет их проблемой. Такой файл конкурирует с живой страницей и со временем устаревает.
Четвёртое: сканы. Договор или прайс, сфотографированный и вставленный в PDF, для поиска и ИИ пуст. Вы платили за его размещение, а видимости он не даёт.
Как подготовиться
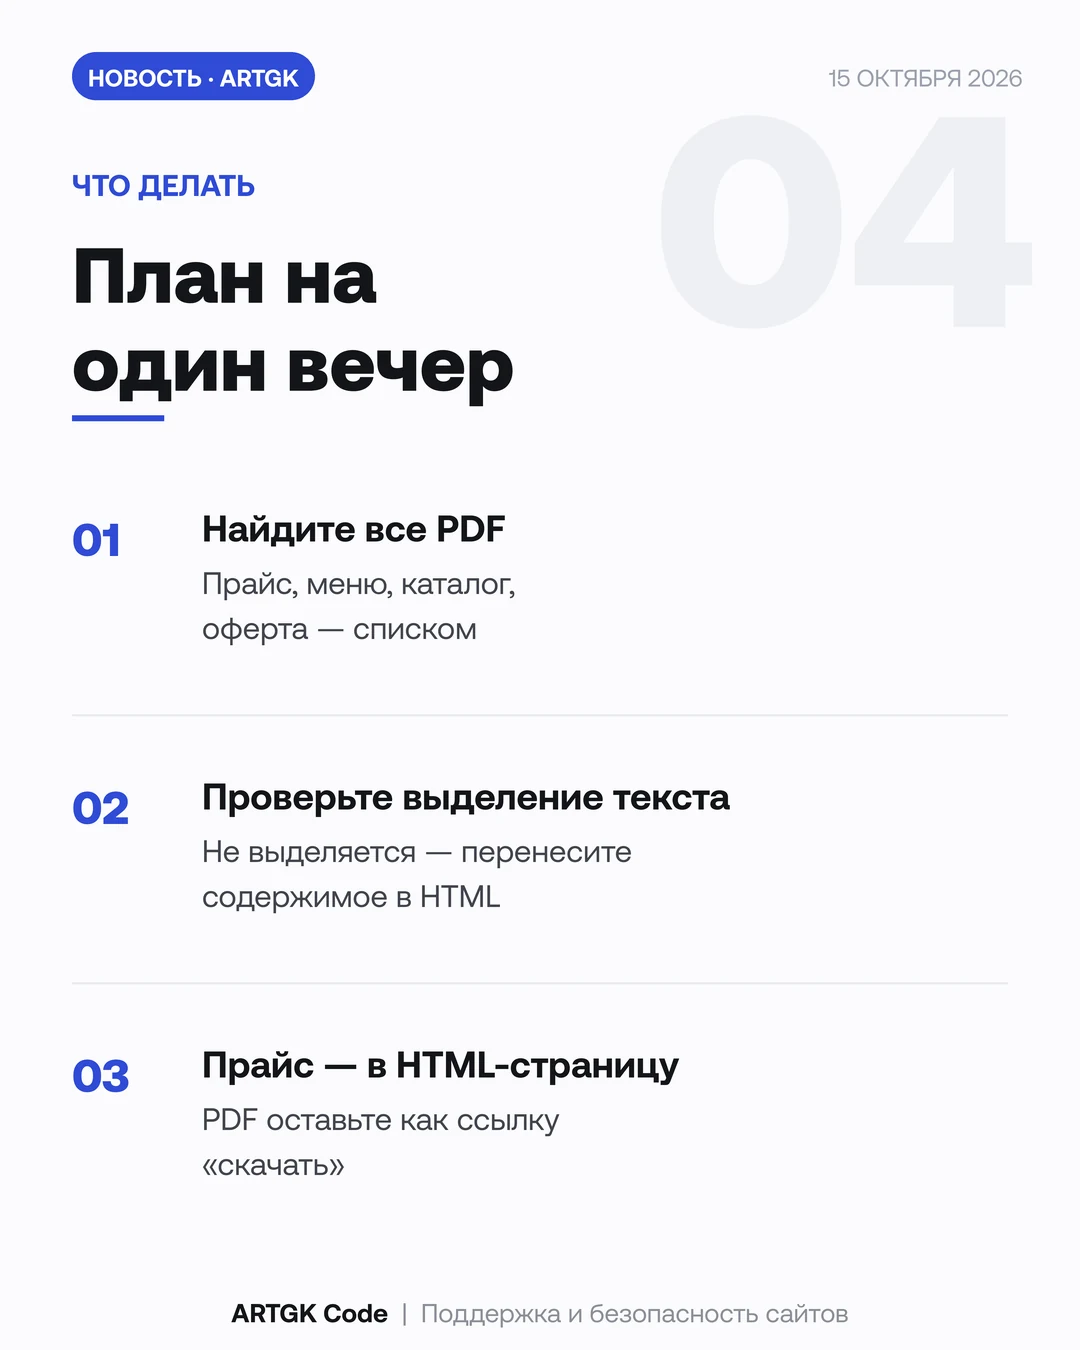
- Составьте список всех PDF на сайте. Для Битрикса это папка /upload/ и файлы в разделах «Документы» и «Прайс».
- Откройте каждый и попробуйте выделить текст. Не выделяется, значит это скан. Перепишите содержимое в HTML-страницу.
- Для прайса, меню и каталога сделайте страницу в HTML. PDF оставьте как ссылку «скачать».
- В PDF, которые остаются, положите заметную ссылку на нужную страницу сайта. Заполните название и описание в свойствах файла.
- Автоматические PDF-копии страниц отключите или закройте от индексации. Как закрыть, смотрите в документации Google.
- Обновляете прайс? Выкладывайте под новым именем и меняйте ссылки. Старый удалите или перенаправьте.
- Не оставляйте файл под паролем, если хотите, чтобы его находили в поиске.
Про Яндекс в этом выпуске речи нет, и мы не берёмся утверждать, что он ведёт себя так же. Но базовые советы работают в любом случае: текст в HTML читают и роботы, и люди, и нейросети.
Отдельно о картинках. Если в PDF лежит схема проезда, таблица размеров или график цен, у этих картинок нет своего адреса. Они не попадут в поиск по картинкам, а их содержимое роботу придётся угадывать. Выносите важное в обычный текст рядом, а картинку кладите на страницу как отдельный файл с подписью alt.
Как понять, сколько на вас это влияет: откройте Google Search Console, раздел с отчётом по эффективности, и отфильтруйте адреса, оканчивающиеся на .pdf. Если файлы собирают показы, значит люди приходят на них из поиска, и эти файлы надо привести в порядок первыми.
Коротко
- Google превращает PDF в HTML и ранжирует его как страницу. Может показать и в ответах ИИ.
- Предпочтение у HTML: быстрее, удобнее, понятнее роботу.
- Скан без текста поиску не виден.
- Старый PDF перескакивается реже, цены в нём устаревают незаметно.
- Начните с прайса: перенесите его в HTML-страницу. Это вечер работы, а не проект.
Сделаем под ключ — заказ из кабинета по согласованной смете. 2 900 ₽
Посмотреть в маркетплейсе →