Сайт пропал из поиска: проверяем robots.txt и noindex
Сайт пропал из поиска целиком? Первым делом проверьте два места: файл robots.txt и метку noindex. Разбираем, где искать запрет, чем они отличаются и сколько ждать после исправления.
- Как понять, что сайт пропал из поиска, а не просто просел в позициях?
- Что такое robots.txt и noindex простыми словами?
- Откуда берётся запрет, если вы его не ставили?
- Как проверить robots.txt за минуту без доступа к админке?
- Как найти noindex на странице?
- Почему robots.txt и noindex вместе не работают?
- Где в 1С-Битрикс и Аспро смотреть robots.txt?
- Нашли запрет: что делать по шагам?
- Что смотреть в Яндекс Вебмастере и Google Search Console?
- Что вы увидите в кабинете ARTGK Code по этой теме?
- Сколько ждать возвращения в поиск после исправления?
- Чем Яндекс и Google понимают robots.txt по-разному?
- Какие ошибки с robots.txt и noindex стоит знать заранее?
- Источники
Что вы получите из статьи:
- как за две проверки без доступа к коду понять, закрыт ли сайт от Яндекса и Google
- где в 1С-Битрикс лежит robots.txt (Маркетинг > Поисковая оптимизация > Настройка robots.txt)
- почему запрет в robots.txt и noindex на странице вместе не работают - по справкам обоих поисковиков
- какие сроки возврата называют официальные справки, без обещаний
- что покажет бесплатная проверка в кабинете ARTGK Code по этой теме
Из практики: применить можно за 15-20 минут, экономит часы на поиск причины и споры с подрядчиком.
Типичная техническая причина, по которой сайт пропадает из поиска целиком, - запрет, оставшийся со стадии разработки или переезда: строка Disallow: / в файле robots.txt или метка noindex на страницах. Цифры из справок поисковиков такие: Google кэширует robots.txt до 24 часов, Яндекс удаляет закрытую страницу из базы в течение недели, а к самой странице Google после исправления может возвращаться месяцами. Проверка занимает 15-20 минут и не требует доступа к коду. Хватит браузера и адреса вашего сайта.
Если хочется сразу понять, открыта ли главная страница для роботов, это показывает бесплатная проверка в кабинете ARTGK Code: для начала нужен только email. Ниже - ручной порядок, он работает и без кабинета.
Как понять, что сайт пропал из поиска, а не просто просел в позициях?
Проверьте два признака. Первый: введите в Яндексе и в Google название компании в кавычках, затем отдельным запросом адрес сайта. Второй: откройте Вебмастер и посмотрите график страниц в поиске. В справке Яндекса про этот график написано: «Резкое изменение количества добавленных или участвующих в поиске страниц может быть связано с изменениями на сайте. Например, со сменой структуры сайта или файла robots.txt» (Яндекс).
У Google похожий сигнал описан в отчёте об индексировании страниц: если общее число проиндексированных страниц падает, а ошибок не прибавляется, возможно, доступ к страницам закрыт через robots.txt, noindex или обязательный вход (Search Console). Если сайт не открывается вообще, причина другая, и порядок действий описан в статье «Сайт не открывается: что делать по шагам».
Что такое robots.txt и noindex простыми словами?
Файл robots.txt лежит в корне сайта и говорит роботу, какие адреса ему можно открывать. Метка noindex - это строка в коде страницы или заголовок ответа сервера. Робот должен прочитать страницу, чтобы её увидеть. Запись выглядит так: <meta name="robots" content="noindex">.
Справка Google разводит эти понятия прямо: «Файл robots.txt не предназначен для того, чтобы запрещать показ ваших материалов в результатах поиска Google» (Google). Чтобы скрыть страницу, там советуют noindex или доступ по паролю. В справке Яндекса про метатеги сказано: noindex означает «Не индексировать текст страницы. Страница не будет участвовать в результатах поиска» (Яндекс).
Есть и третья запись, которую новички не узнают: content="none". В справке Яндекса сказано, что none «соответствует директивам noindex, nofollow», то есть тоже закрывает страницу (Яндекс).
Откуда берётся запрет, если вы его не ставили?
Типовой сценарий выглядит так. Подрядчик собирает новый сайт на тестовом поддомене и закрывает его от роботов, чтобы тест не попал в поиск. Потом сайт переносят на основной домен, а Disallow: / остаётся. Поэтому заглядывать в этот файл стоит в день переезда или запуска нового сайта. Вторая версия: после переезда на другой хостинг или смены движка файл подменили шаблонным.
Яндекс в таблице причин исключения страниц предлагает порядок действий: убрать запрещающие директивы, а если вы сами запрет не ставили, спросить хостинг-провайдера или регистратора домена. Рядом стоит ещё одна проверка: не заблокировали ли домен из-за истечения срока регистрации (Яндекс). Про продление домена читайте в статье «Автопродление домена включено: что ещё проверить владельцу сайта».
Закрыта ли ваша главная от роботов, видно в кабинете ARTGK Code: пункт «Главная не скрыта от поиска» входит в бесплатную проверку. Доступ к сайту для этого не нужен, на странице artgk.app/business создаётся кабинет по одному email. Если проверка покажет проблему, дальше можно идти по шагам ниже и сверять картину руками.
Как проверить robots.txt за минуту без доступа к админке?
User-agent: * или User-agent: Yandex строку Disallow: /. Она закрывает весь сайт. Файл должен открываться с кодом 200, весить не больше 500 КБ и лежать в корне сайта. Весь осмотр занимает около минуты и не требует доступа к админке.Порядок из четырёх шагов:
- Откройте в приватном окне адрес
https://ваш-сайт.ru/robots.txt: так вы увидите файл без своего кэша. В справке Google пример такой: для сайта www.example.com файл лежит по адресу www.example.com/robots.txt (Google). - Найдите блок для всех роботов (
User-agent: *) и блок для Яндекса (User-agent: Yandex). - Посмотрите строки
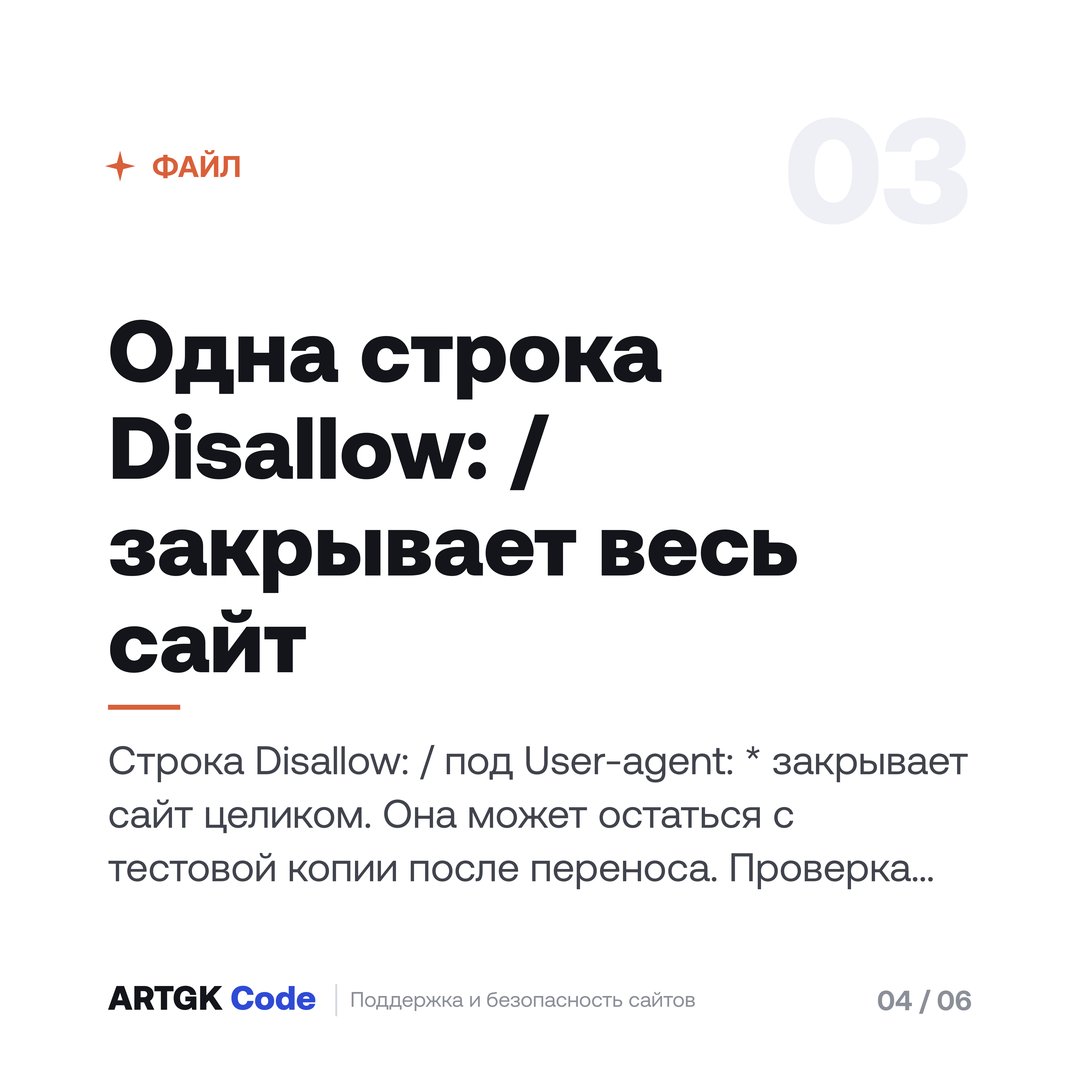
Disallow. СтрокаDisallow: /закрывает весь сайт: в примере из справки Яндекса у неё комментарий «запрещает обход всего сайта» (Яндекс). АDisallow: /adminпрячет от роботов один раздел, и это нормально. - Проверьте код ответа в бесплатном инструменте Яндекса «Проверка ответа сервера». Яндекс требует, чтобы сервер отдавал файл с кодом 200 OK, и сам файл должен весить не больше 500 КБ (Яндекс). У Google при ошибке 4xx (кроме 429) робот считает, что файла нет и ограничений нет, а после не менее чем 5 перенаправлений подряд файл трактуется как 404 (Google).
Требования к файлу у Яндекса строгие. В справке написано: «Если файл не соответствует требованиям, сайт считается открытым для индексирования».
Для проверки правил есть бесплатный «Анализ robots.txt» от Яндекса. Он показывает, какие страницы разрешены или запрещены для индексации, и работает даже для сайта, не добавленного в Вебмастер (Яндекс). Закрыта ли от роботов главная, кабинет ARTGK Code проверяет сам.
Как найти noindex на странице?
content="noindex" или content="none" закрывает страницу от поиска. Есть и скрытый вариант: заголовок X-Robots-Tag в ответе сервера. Его видно в инструментах разработчика по клавише F12, а в коде самой страницы его нет.Шаги такие:
- Откройте нужную страницу и нажмите Ctrl+U: откроется исходный код.
- Нажмите Ctrl+F и введите
robots, затем отдельноnoindex. - Если нашлась строка
<meta name="robots" content="noindex">, страница закрыта от всех поисковиков, понимающих эту директиву. - Если в коде метки нет, а страница всё равно не в поиске, откройте вкладку «Сеть» в инструментах разработчика (F12) и посмотрите заголовки ответа: там может стоять
X-Robots-Tag: noindex.
По описанию Google, заголовок X-Robots-Tag закрывает и файлы, которые нельзя разметить тегом: PDF, видео, изображения (Google). Справочник MDN называет его неофициальным, но общепринятым методом: «de-facto standard» (MDN).
Не путайте метку на всю страницу с элементом <noindex>...</noindex> в тексте: в справке Яндекса он описан как способ скрыть от индексирования часть текста. Следите за закрывающим тегом: если его нет, скрытым считается весь контент страницы (Яндекс).
Почему robots.txt и noindex вместе не работают?
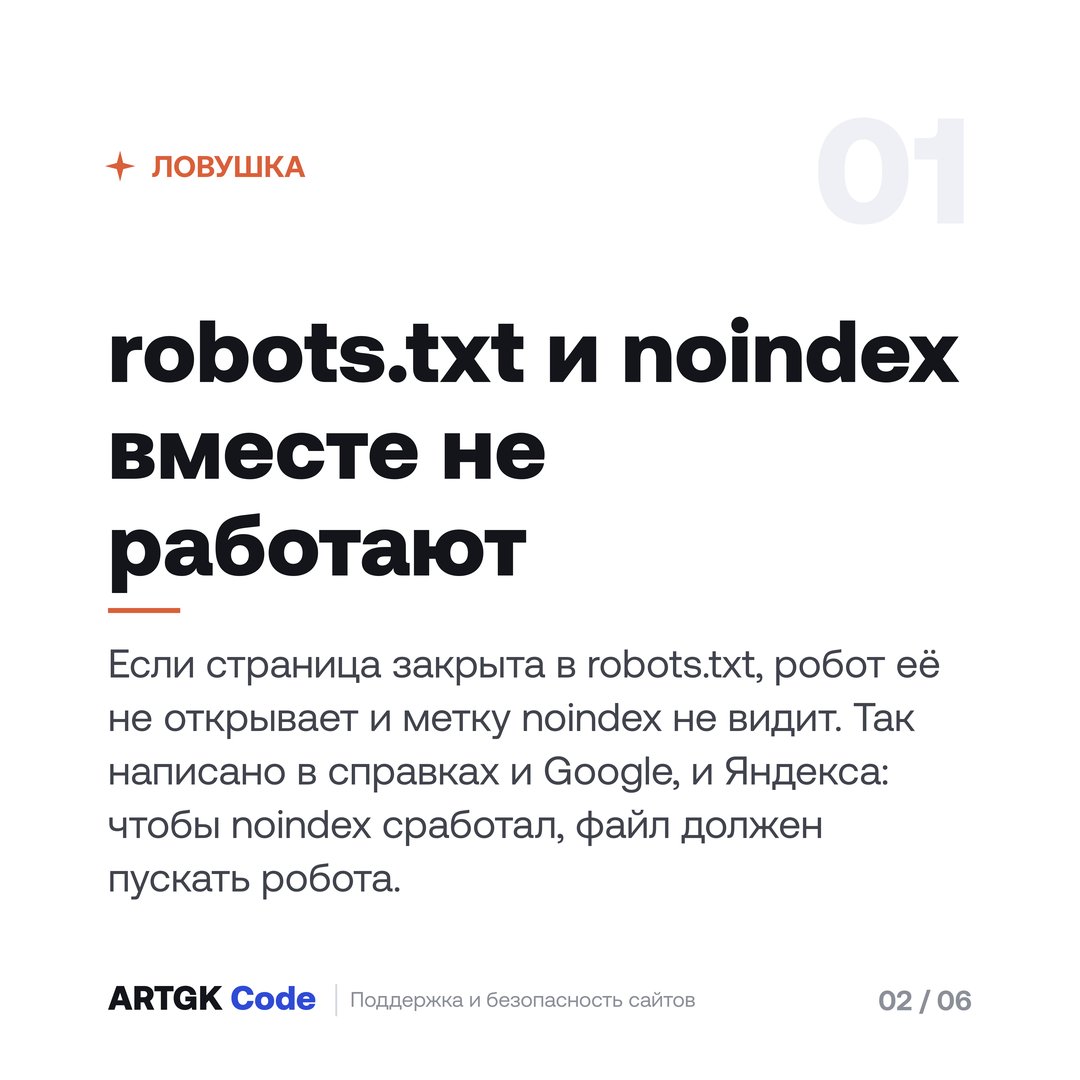
Это главная ловушка темы. Владелец или подрядчик хочет закрыть страницу надёжнее: пишет Disallow и добавляет noindex. Получается наоборот. Google пишет: «Чтобы правило noindex работало, файл robots.txt не должен блокировать поисковому роботу доступ к странице. В противном случае поисковый робот не сможет обработать ее код и не обнаружит правило noindex» (Google). В той же справке добавлено, что контент такой страницы может по-прежнему появляться в результатах, например если на неё ссылаются другие ресурсы.
Яндекс говорит то же короче: «Если страница запрещена в файле robots.txt, то директива метатега или заголовка не действует» (Яндекс). В справке Яндекса про robots.txt добавлено: «Ограниченные в robots.txt страницы могут участвовать в поиске Яндекса» (Яндекс).
Вывод для практики: хотите убрать страницу из поиска - оставьте её открытой для робота и поставьте noindex. Хотите только снизить нагрузку на сервер - закрывайте обход файлом. Задачи разные, и инструменты для них разные.
Где в 1С-Битрикс и Аспро смотреть robots.txt?
В документации 1С-Битрикс сказано: «Начиная с версии 14.0.0 модуля Поисковая оптимизация, вам больше не потребуется создавать вручную файл robots.txt для вашего сайта. Теперь его создание можно выполнять с помощью специального генератора, который доступен на странице Управление robots.txt (Маркетинг > Поисковая оптимизация > Настройка robots.txt)» (Битрикс).
Из того же урока: если файл уже есть, форма покажет его содержимое. Если в системе несколько сайтов, переключитесь на нужный. Отдельно про правила: у Яндекса в файле допустим только 1 блок User-agent: *, остальные роботы описываются отдельными блоками (Яндекс). В уроке также сказано: кнопка «Стартовый набор» создаёт базовый рекомендованный набор правил и при этом спрашивает главное зеркало сайта.
Если в Битриксе вы увидели Disallow: /, не торопитесь стирать строку. Сначала сохраните старое содержимое файла и спросите подрядчика, зачем оно там появилось.
Нашли запрет: что делать по шагам?
Disallow: / или метку noindex, проверьте результат в «Анализе robots.txt» и запросите переобход важных страниц в Вебмастере. Яндекс называет срок обновления данных до двух недель, а Google перечитывает файл robots.txt до 24 часов.Порядок действий:
- Сохраните копию текущего файла или кода страницы: если запрет ставили не вы, вам понадобится объяснение, зачем он нужен.
- Уберите строку
Disallow: /из robots.txt или метку noindex из страницы. Для noindex убирать метку надо в шаблоне или настройках движка, откуда она попадает на страницу. - Проверьте файл в бесплатном «Анализе robots.txt» от Яндекса и откройте его в браузере: он должен открываться с кодом 200 и весить не больше 500 КБ.
- В Яндекс Вебмастере запросите переобход главной и ключевых страниц. Лимит заявок обновляется ежедневно (Яндекс).
- В Search Console откройте отчёт о robots.txt и при необходимости запросите повторный обход файла: Google допускает это для экстренных случаев (Google).
- Если часть страниц нужно закрыть намеренно, закрывайте их одним способом: для скрытия из поиска оставьте доступ роботу и поставьте noindex. Страницы, которые отдают код 404, 403 или 410, Яндекс тоже убирает из базы в течение недели после того, как робот обнаружит ответ. Для срочного удаления у Яндекса есть инструмент «Удаление страниц из поиска»: до 500 адресов одного сайта в сутки (Яндекс).
Что смотреть в Яндекс Вебмастере и Google Search Console?
Яндекс описывает путь так: «Индексирование → Страницы в поиске», затем «Исключённые страницы». В таблице причин будет строка про запрет в robots.txt или метатегом noindex (Яндекс). Там же перечислены и другие причины исключения: код ответа сервера 3XX (перенаправление), 4XX (ошибка запроса) или 5XX (ошибка сервера), редирект, дубль, страница-копия, которую поисковик не считает главной, малоценная страница.
Отчёт о robots.txt в Search Console показывает файлы, найденные для 20 основных хостов сайта (хост - вариант адреса, например с www и без), время последнего обхода и ошибки. В нём можно запросить повторный обход файла «в экстренных случаях». Отчёт доступен только для доменного ресурса, то есть когда в Search Console добавлен весь домен целиком, а адрес появляется в нём, если за последние 30 дней у него был статус «Получен» или «Не получен» (Search Console).
Есть и сетевая причина. По справке Google, при ошибке 5xx на адресе robots.txt первые 12 часов обход сайта остановлен, а следующие 30 дней используется последняя рабочая версия файла (Google). Если сайт падает и поднимается, быстрее узнавать об этом помогает мониторинг: подробности в статье «Мониторинг доступности сайта».
Что вы увидите в кабинете ARTGK Code по этой теме?
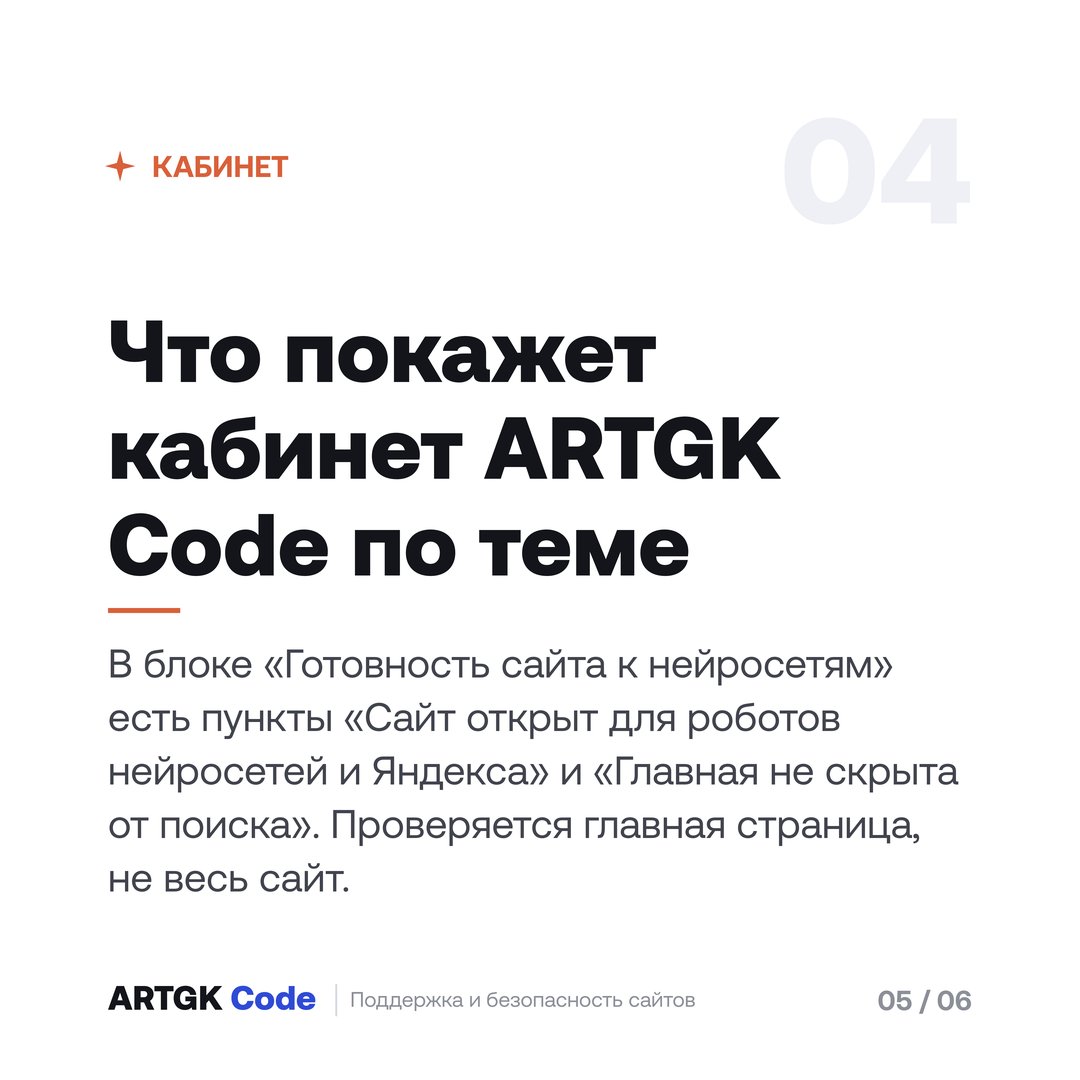
Откройте демо-кабинет: он работает без регистрации, на демонстрационных данных, изменения в нём не сохраняются. В карточке сайта нужная вам вкладка - «Видимость в AI». Там блок «Готовность сайта к нейросетям» показывает чек-лист. В демо у него итог «8 в порядке · 1 доработать», а среди пунктов, важных для этой темы:
- «Сайт открыт для роботов нейросетей и Яндекса»;
- «Главная не скрыта от поиска»;
- «Карта сайта (sitemap.xml)».
В вашем кабинете проверка запускается сама после добавления сайта, а вкладка «История» хранит результаты проверок с датами. Если нужна правка, кнопка «Поручить доработки нам» отправляет задачу специалисту. Он бесплатно оценит работу и пришлёт стоимость, а списания без вашего подтверждения не будет.
Чего кабинет не делает. Он не проверяет каждое правило в robots.txt и каждую страницу на noindex, не показывает статус индексации в Яндексе и Google. Для этого есть Вебмастер и Search Console из предыдущего раздела. Кабинет отвечает на первый вопрос: не закрыта ли от роботов главная. Подробнее о бесплатной проверке читайте в статье «Как бесплатно проверить сайт», а про нейросети - в статье «Почему ChatGPT и Алиса не советуют вашу компанию».
Сколько ждать возвращения в поиск после исправления?
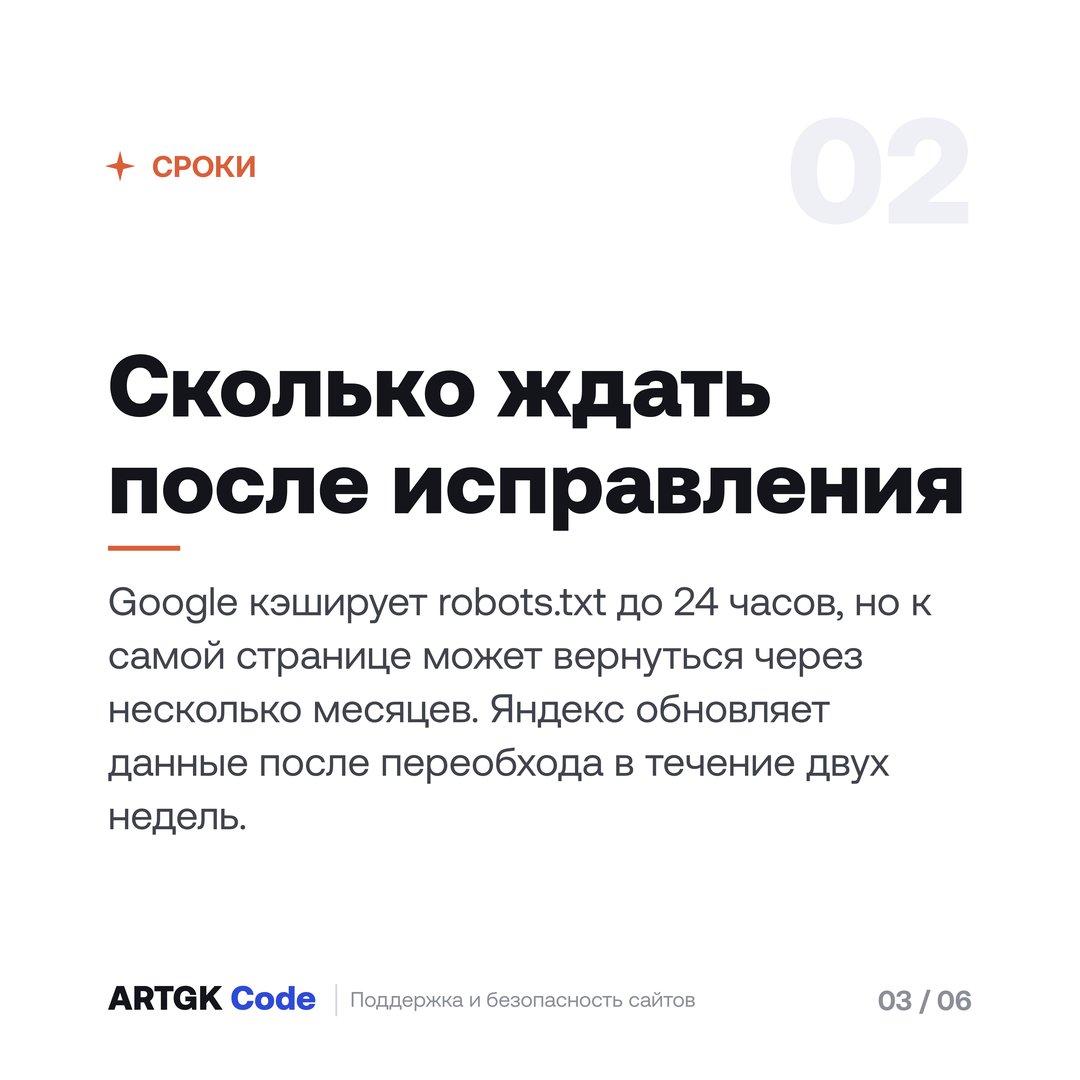
Что написано в справках. Google обычно кэширует файл до 24 часов, и срок может быть дольше, если обновить копию не получается (Google). К самим страницам Google возвращается дольше. В справке про noindex сказано: «Робот Googlebot может повторно посетить страницу только спустя несколько месяцев» (Google).
Яндекс: после запроса на переобход статус «Заявка обработана» означает, что «Робот посетил страницу. Данные обновятся в течение двух недель». Там же отмечено, что статус не означает, что робот проиндексировал страницу (Яндекс). Лимит заявок ежедневный, точное число в справке не названо. Если вы, наоборот, закрыли страницу намеренно, справка Яндекса называет срок исчезновения: «Из поисковой базы страница будет удалена в течение недели после того, как робот обнаружит ваши указания» (Яндекс). Для ответов Алисы AI срок другой: изменение в robots.txt учитывается «в течение 2-14 дней» (Яндекс).
Эти цифры - ориентиры из справок, а не обещание. Google пишет, что срок зависит от важности страницы. Сколько ждать именно вам, предсказать нельзя, и честный ответ - наблюдать за графиком в Вебмастере. Позиции и трафик после возврата справки не обещают.
Чем Яндекс и Google понимают robots.txt по-разному?
| Что проверяем | Яндекс | |
|---|---|---|
| Размер файла | не больше 500 КБ (Яндекс) | лимит 500 КиБ, остальное игнорируется (Google) |
| Поддерживаемые директивы | 5: User-agent, Disallow, Sitemap, Clean-param, Allow | 4 поля: user-agent, allow, disallow, sitemap (Google) |
| Crawl-delay | не учитывается с 22 февраля 2018 года (Яндекс) | не поддерживается (Google) |
| Host | отменена 20 марта 2018, замена - 301-редирект на главное зеркало (блог Яндекса) | не поддерживается |
| noindex в robots.txt | такого способа в справке нет | прямо сказано: «Google не поддерживает указание правила noindex в файле robots.txt» (Google) |
| Число правил | не больше 2048 (справочник ошибок) | - |
Практический вывод: директивы Host и Crawl-delay из файла можно убрать, на поведение роботов они уже не влияют. Яндекс отдельно писал, что в файлах встречались значения Crawl-delay 20, 50 и даже 100, хотя при значении больше 2 скорость обхода сайта сильно снижалась (блог Яндекса).
Какие ошибки с robots.txt и noindex стоит знать заранее?
Disallow: / с тестовой копии, связка Disallow и noindex на одной странице, noindex внутри robots.txt, надежда на файл как на защиту, ошибка 5xx на адресе файла и удаление через инструмент без правки сайта. Часть из них закрывает сайт сразу, часть подводит позже, когда о ней уже забыли.Disallow: /с тестовой копии. Закрывает весь сайт.- Disallow плюс noindex на одной странице. Метка не работает, пока робота не пускает файл.
- noindex внутри robots.txt. Google такую запись не поддерживает.
- Спрятать секретные разделы в robots.txt. Стандарт RFC 9309 (сентябрь 2022) говорит прямо, что правила robots.txt не служат способом ограничения доступа. Пути, перечисленные в файле, становятся публично видны (RFC 9309). Метод, как отмечено в том же RFC, придумал Мартейн Костер в 1994 году. По RFC робот не должен хранить копию файла дольше 24 часов, а разбирать он обязан не менее 500 КиБ. На сайте robotstxt.org предупреждают: файл общедоступен, поэтому скрывать в нём информацию не нужно (robotstxt.org).
- Ошибка 5xx на адресе /robots.txt. Если файл отвечает ошибкой 5xx, Google на первые 12 часов останавливает обход всего сайта.
- Удаление через инструмент Google без правки сайта. Успешный запрос в инструменте удаления действует около 6 месяцев (Search Console). Если запрет на сайте не поставлен, страница вернётся в выдачу через это время.
Про остальные технические ошибки, видимые за 5 минут, читайте в статье «10 SEO-ошибок, которые видны за 5 минут бесплатной проверки».
Источники
- Введение в robots.txt от Google: developers.google.com
- Блокировка индексирования через noindex, Google: developers.google.com
- Как Google читает robots.txt: developers.google.com
- Создание файла robots.txt, Google: developers.google.com
- Метатег robots и заголовок X-Robots-Tag, Google: developers.google.com
- Отчёт о robots.txt в Search Console: support.google.com
- Отчёт об индексировании страниц, Search Console: support.google.com
- Удаление адресов из выдачи, Search Console: support.google.com
- Требования Яндекса к файлу robots.txt: yandex.ru
- Метатеги и HTTP-заголовки в Вебмастере Яндекса: yandex.ru
- Таблица причин исключения страниц, Яндекс: yandex.ru
- Удаление страниц из поиска, Яндекс: yandex.ru
- Переобход страниц по заявке, Яндекс: yandex.ru
- Генератор robots.txt, документация 1С-Битрикс: dev.1c-bitrix.ru
- Директивы Disallow и Allow, Яндекс: yandex.ru
- Анализ robots.txt, Яндекс: yandex.ru
- Страницы в поиске, Вебмастер Яндекса: yandex.ru
- Директива Crawl-delay, Яндекс: yandex.ru
- Ошибки в robots.txt, справочник Яндекса: yandex.ru
- Отмена директивы Host, блог Яндекса: webmaster.yandex.ru
- Заголовок X-Robots-Tag, MDN: developer.mozilla.org
- Что такое /robots.txt: robotstxt.org
- RFC 9309, протокол исключений для роботов: rfc-editor.org
Хотите увидеть, как выглядит такая проверка, до регистрации? Откройте демо-кабинет ARTGK Code: в нём можно пройти по вкладкам сайта и посмотреть блок «Готовность сайта к нейросетям».