Как проверить, доступны ли страницы сайта поисковым ИИ-ботам
Нейросети ходят на сайт разными роботами: одни собирают данные для обучения, другие для поиска, третьи по просьбе пользователя. Разбираем, как проверить доступ каждого: robots.txt, Вебмастер, Search Console, защиту хостинга и журналы.
- Какие ИИ-боты заходят на сайт и чем они отличаются?
- Каких ботов нельзя закрывать, если хотите попадать в ответы нейросетей?
- Как Google и Яндекс пускают сайт в ИИ-ответы, если отдельного бота нет?
- Как прочитать robots.txt глазами конкретного бота?
- Почему отдельная строчка для GPTBot может открыть ему служебные разделы?
- Как проверить robots.txt в Яндекс Вебмастере и Google Search Console?
- Что вы увидите в кабинете ARTGK Code по этой теме?
- Почему бот получает отказ, хотя robots.txt всё разрешает?
- Как проверить ответ сервера под именем бота - и почему это ещё не доказательство?
- Что покажут журналы сервера и как попросить их у хостинга?
- Видит ли ИИ-бот текст, если страницу собирает JavaScript?
- Сколько ждать, пока нейросети заметят исправление?
- Какие ошибки с ИИ-ботами в robots.txt встречаются чаще всего?
- Источники
Что вы получите из статьи:
- какие ИИ-боты заходят на сайт и кого из них нельзя закрывать, если хотите в ответы ChatGPT, Claude и Perplexity - по документации самих компаний
- почему у Google и Яндекса нет отдельного ИИ-бота и что проверять вместо него
- как одна строчка для GPTBot в robots.txt отменяет общие правила - с цитатами Google, Яндекса и стандарта
- как без командной строки проверить robots.txt в Яндекс Вебмастере и Google Search Console
- что попросить у хостинга, если боты получают 403 или проверку на робота
Из практики: применить можно за 20-30 минут, экономит недели догадок, почему нейросеть вас не видит.
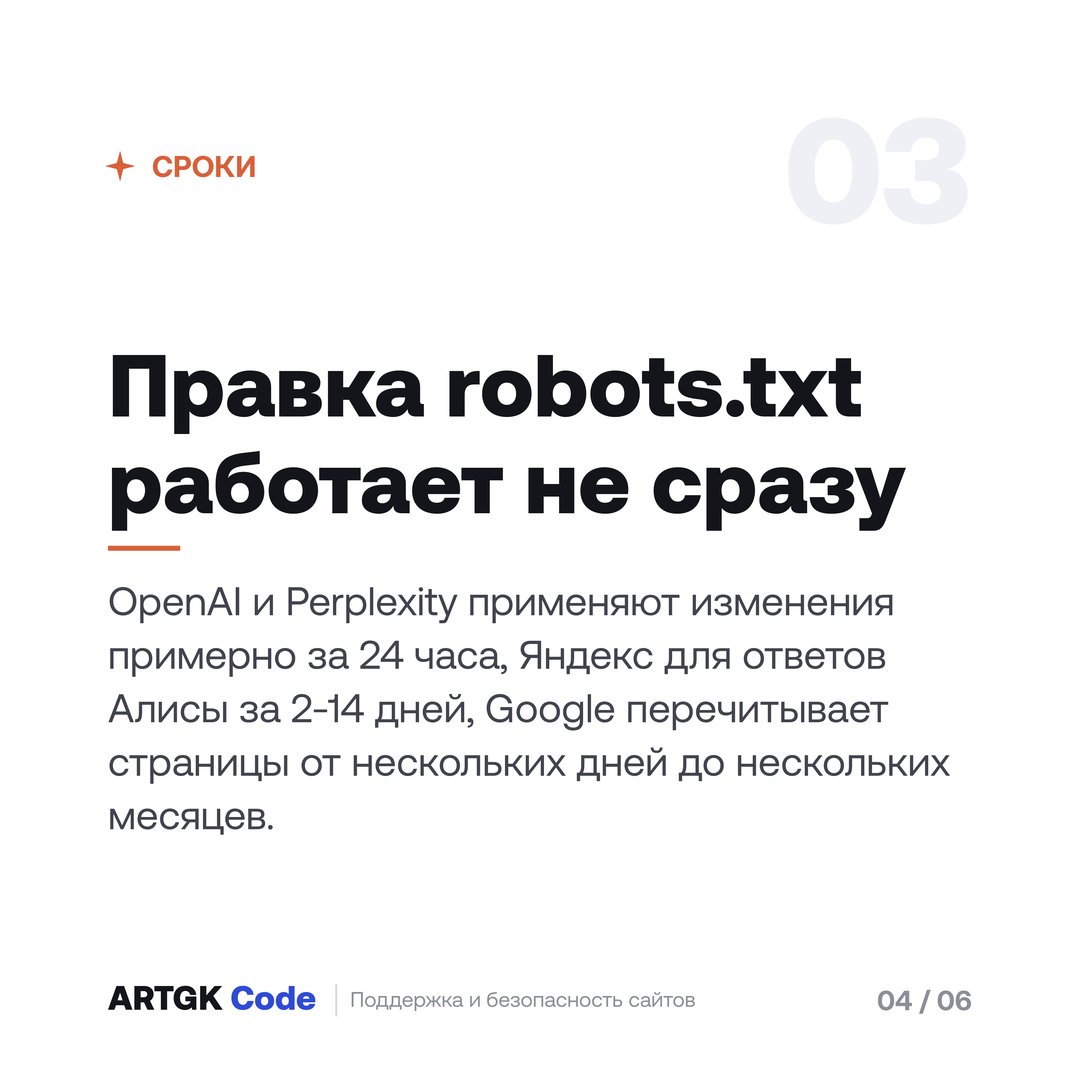
Проверка доступа поисковых ИИ-ботов к сайту состоит из трёх слоёв: правила в robots.txt для каждого бота, защита хостинга или CDN, которая может ответить роботу отказом раньше, чем он прочтёт файл, и журналы сервера, где видно, кто реально заходил. По документации сервисов правка robots.txt вступает в силу не сразу: у OpenAI около 24 часов, у Perplexity до 24 часов, у Яндекса запрет для ответов Алисы применяется 2-14 дней, а Google перечитывает страницы от нескольких дней до нескольких месяцев. На всю ручную проверку уйдёт 20-30 минут.
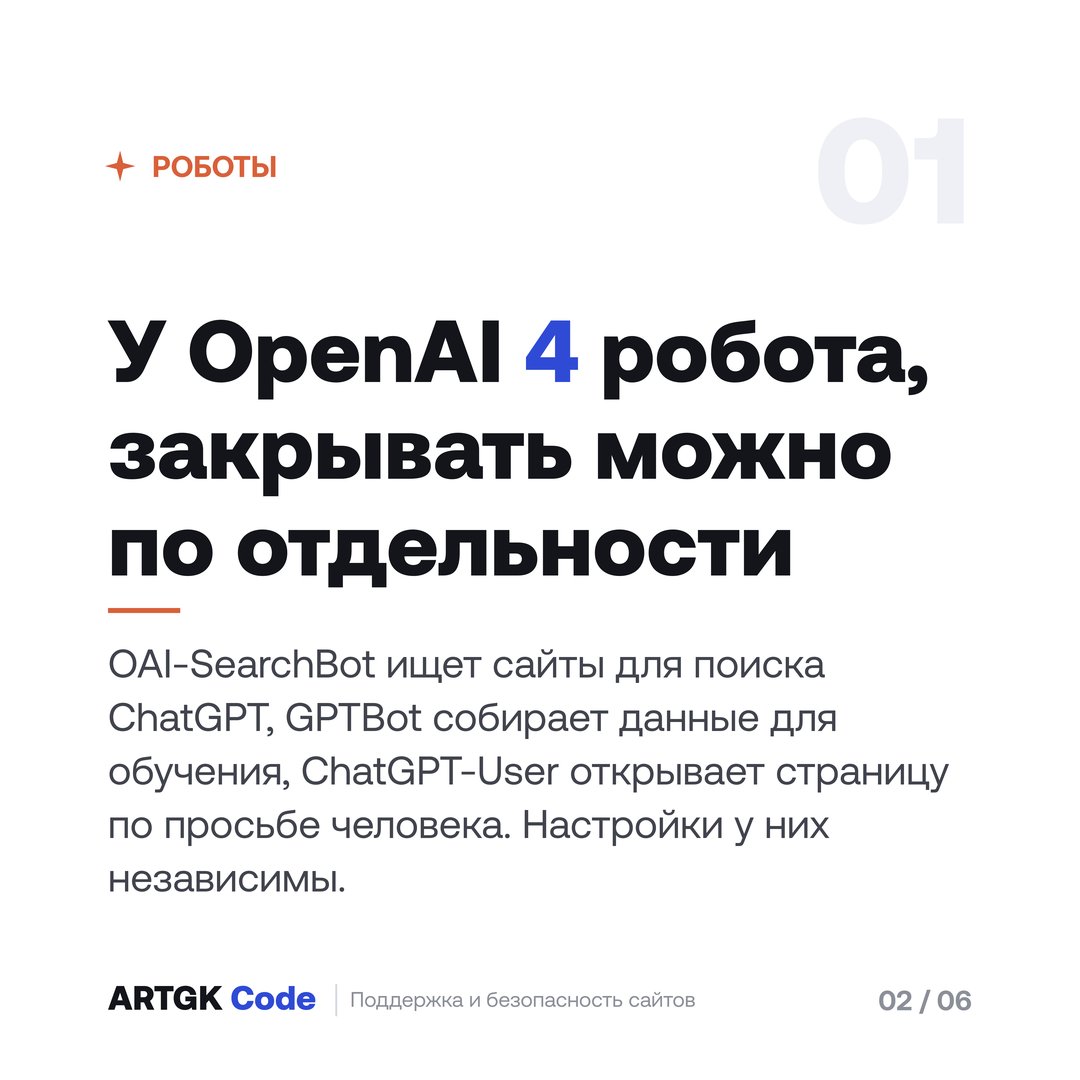
У ChatGPT, Claude и Perplexity есть собственные поисковые роботы, а Google и Яндекс строят ИИ-ответы из обычного поискового индекса. Поэтому проверять их придётся по-разному. В таблице первого раздела 12 имён от пяти компаний и отметка, слушается ли каждый robots.txt: у OpenAI 4 робота (рекламный OAI-AdsBot в таблицу не вошёл), у Anthropic 3, у Perplexity 2.
Если хочется сразу увидеть общую картину, бесплатная проверка в кабинете ARTGK Code показывает, открыт ли сайт для роботов нейросетей и Яндекса и не скрыта ли главная страница от поиска. Для начала нужен только email. Ручной порядок ниже работает и без кабинета.
Какие ИИ-боты заходят на сайт и чем они отличаются?
OpenAI формулирует это прямо: «Each setting is independent of the others» (каждая настройка не зависит от остальных). Можно пустить OAI-SearchBot, чтобы сайт появлялся в поиске ChatGPT, и закрыть GPTBot, чтобы контент не шёл на обучение моделей (OpenAI).
| Имя в robots.txt | Для чего | Слушается robots.txt |
|---|---|---|
| OAI-SearchBot (OpenAI) | поиск в ChatGPT | да |
| GPTBot (OpenAI) | сбор данных для обучения | да |
| ChatGPT-User (OpenAI) | открывает страницу, когда пользователь задал вопрос | может не слушаться |
| Claude-SearchBot (Anthropic) | улучшает качество поиска Claude | да |
| Claude-User (Anthropic) | открывает страницу по запросу пользователя Claude | да, по описанию Anthropic |
| ClaudeBot (Anthropic) | сбор данных для обучения | да |
| PerplexityBot (Perplexity) | поиск Perplexity, на обучение не идёт | да |
| Perplexity-User (Perplexity) | открывает страницу по вопросу пользователя | обычно нет |
| Googlebot (Google) | обычный поиск, из него же строятся AI Overviews и AI Mode | да |
| Google-Extended (Google) | только правило для Gemini, робота с таким именем нет | само правило, не робот |
| YandexBot (Яндекс) | основной индексирующий робот | да |
| YandexAdditional (Яндекс) | только правило для ответов Поиска с Алисой, на сайт не ходит | само правило, не робот |
Версии в подписях на сегодня такие: OAI-SearchBot/1.4, GPTBot/1.4, ChatGPT-User/1.0, PerplexityBot/1.0, YandexBot/3.0. Они меняются, поэтому в журналах ищите имя без версии.
Источники таблицы: страницы OpenAI, Anthropic, Perplexity, Google и Яндекса.
Особняком стоят боты, которые действуют по просьбе человека. OpenAI пишет про ChatGPT-User: «Because these actions are initiated by a user, robots.txt rules may not apply» (поскольку действие начинает пользователь, правила robots.txt могут не применяться). У Perplexity то же про Perplexity-User: «this fetcher generally ignores robots.txt rules» (этот загрузчик обычно игнорирует правила robots.txt, Perplexity). У Anthropic иначе: Claude-User, по описанию компании, управляется через robots.txt.
OpenAI ещё держит OAI-AdsBot: он проверяет только страницы, поданные как реклама в ChatGPT. Для обычного сайта он не нужен.
Каких ботов нельзя закрывать, если хотите попадать в ответы нейросетей?
Что будет при закрытии, компании описывают сами. OpenAI пишет: «Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers, though can still appear as navigational links» (сайты, закрытые для OAI-SearchBot, не покажут в ответах поиска ChatGPT, хотя могут появляться как навигационные ссылки, OpenAI). Anthropic про Claude-SearchBot: отключение «may reduce your site's visibility and accuracy in user search results», то есть может снизить видимость и точность сайта в результатах поиска пользователей (Anthropic). Про Claude-User Anthropic пишет, что его отключение «may reduce your site's visibility for user-directed web search» (может снизить видимость сайта, когда пользователь просит Claude поискать в сети). PerplexityBot, по документации, нужен, чтобы показывать сайты в поиске Perplexity, и на обучение моделей не используется.
Закрывать ли GPTBot и ClaudeBot, решаете вы, и оба решения законны. Ни OpenAI, ни Anthropic не публикуют данных о том, что выгоднее малому бизнесу.
Как Google и Яндекс пускают сайт в ИИ-ответы, если отдельного бота нет?
Google пишет: страница, чтобы попасть ссылкой в AI Overviews или AI Mode, «must be indexed and eligible to be shown in Google Search with a snippet» (должна быть в индексе и допускаться к показу в Поиске со сниппетом). Следом идёт фраза «There are no additional technical requirements» (других технических требований нет, Google). Там же сказано, что для этих функций не нужны новые машиночитаемые файлы или «ИИ-файлы». Значит, llms.txt не условие попадания в ответы Google.
Про Google-Extended сказано, что он «does not impact a site's inclusion in Google Search» (не влияет на присутствие сайта в Поиске Google). Отдельной подписи у него нет: обход идёт обычными роботами Google (Google). Если закрыть его, из AI Overviews сайт не уйдёт. Если закрыть Googlebot, сайт перестанут обходить для Поиска целиком.
У Яндекса справка о роботах описывает YandexAdditional так: он применяется при обработке robots.txt, чтобы ограничить показ контента в быстрых ответах с YandexGPT и в ответах Поиска с Алисой, и «не совершает запросов для индексирования» (Яндекс). Поэтому проверять доступ под этой подписью бессмысленно: для индексирования он на сайт не ходит. Применение запрета для Алисы занимает от 2 до 14 дней, так Яндекс писал в 2024 году, когда сервис ещё назывался Нейро (блог Вебмастера). Подробнее про Алису и ChatGPT писали в статье «Почему ChatGPT и Алиса не советуют вашу компанию».
С Microsoft Copilot картина похожая: по документации Microsoft, при включённом веб-поиске он может брать информацию из поиска Bing (Microsoft Learn). Значит, для Copilot важно, видит ли ваш сайт поиск Bing.
Как прочитать robots.txt глазами конкретного бота?
User-agent: *. Своей группы нет - действует общая.Откройте в браузере адрес вашего-сайта.ru/robots.txt. Где файл лежит в Битриксе, описано в отдельной статье про запрет в поиске. Дальше по шагам:
- Найдите строку
User-agent:с именем нужного бота, напримерOAI-SearchBot. Для роботов Яндекса ищите такжеUser-agent: Yandex: эта строка действует на всех роботов Яндекса. - Если такая строка есть, правила бота начинаются после неё и после всех строк
User-agent:, которые идут подряд. Несколько таких строк подряд объединяют ботов в одну группу с общими правилами. Читайте до следующей строкиUser-agent:, которая стоит уже после правил. - Если имя бота встречается в файле в двух местах, правила обоих блоков складываются.
- Если строки с именем нет, читайте блок под
User-agent: *. - Если в нужном блоке стоит
Disallow: /, бот закрыт от всего сайта.
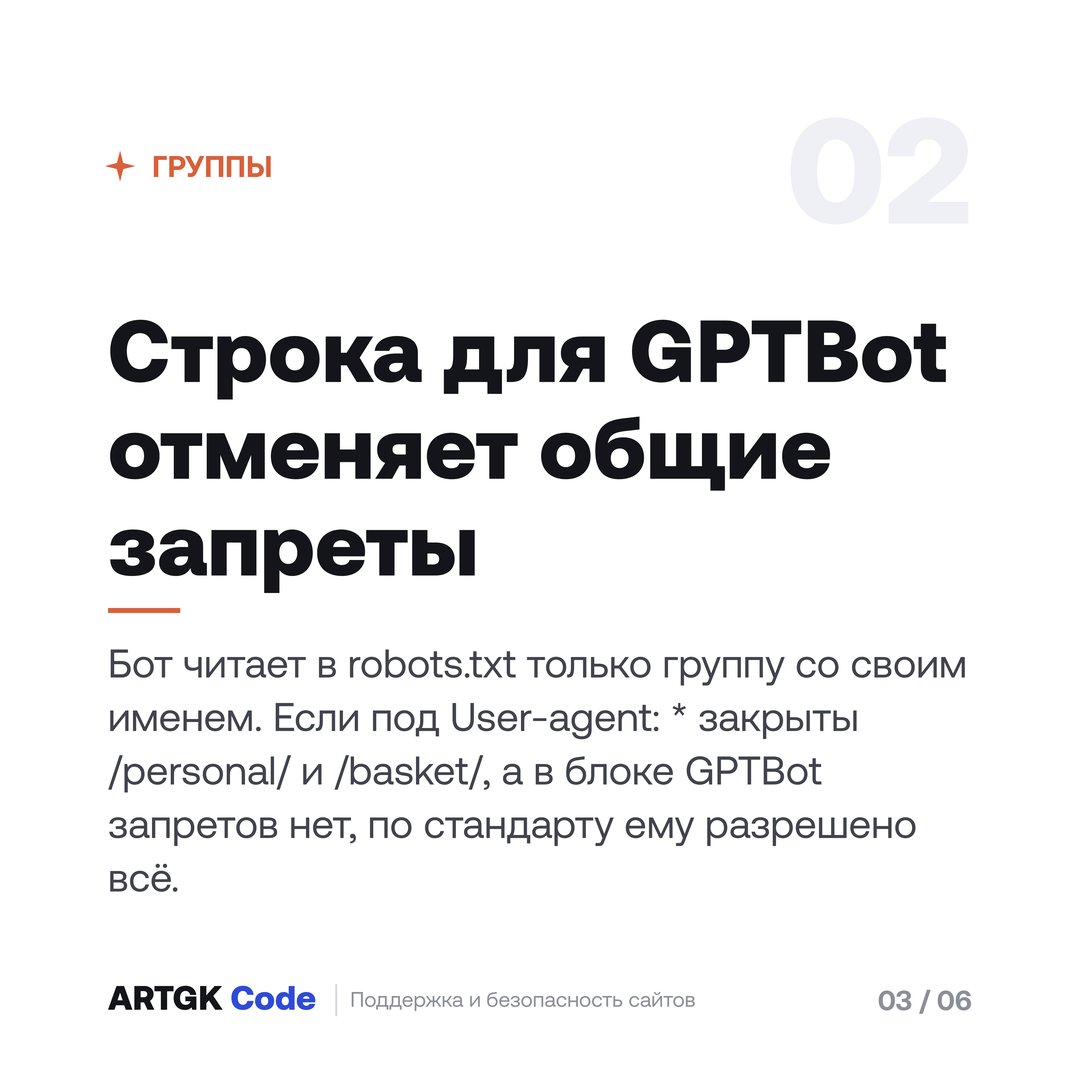
Правило даёт сама спецификация. Google: «Only one group is valid for a particular crawler» (для конкретного робота действует только одна группа). Выбирается группа с самым точным совпадением имени, «Other groups are ignored» (остальные игнорируются), а порядок групп в файле значения не имеет. Там же сказано, что «user agent specific groups and global groups (*) are not combined» (именная группа и общая * не складываются, Google). Яндекс описывает то же для своих роботов: «Если обнаружена строка User-agent: Yandex, то строка User-agent: * не учитывается» (Яндекс).
Почему отдельная строчка для GPTBot может открыть ему служебные разделы?
Типовой пример для магазина на Битриксе:
User-agent: *
Disallow: /bitrix/
Disallow: /personal/
Disallow: /basket/

User-agent: GPTBot
Allow: /catalog/
Хозяин файла хотел сказать «GPTBot пускаем в каталог». Но группа GPTBot читается отдельно, и запретов в ней нет. Стандарт RFC 9309 говорит: если в группе для подходящего робота нет подходящего правила или правил нет совсем, «the URI is allowed» (адрес разрешён, RFC 9309). Выходит, по правилам стандарта GPTBot формально разрешено в том числе /personal/ и /basket/. Как поведут себя конкретные роботы OpenAI, документация отдельно не описывает, но стандарт и справки Google и Яндекса читают файл именно так.
Лечится это просто: повторить нужные запреты в блоке самого бота. Строка Allow: /catalog/ здесь ничего не добавляет: всё, что не запрещено, и так открыто.
User-agent: GPTBot
Allow: /catalog/
Disallow: /bitrix/
Disallow: /personal/
Disallow: /basket/
Если хотели пустить GPTBot только в каталог, пишут Disallow: / и Allow: /catalog/. При конфликте Google берёт самое точное правило, то есть то, у которого путь длиннее, и каталог остаётся открытым (Google).
Бывает и обратная ситуация. Блок User-agent: OAI-SearchBot со строкой Disallow: / закрывает сайт для поиска ChatGPT, даже если общая группа всё разрешает. Такие блоки остаются от прошлого подрядчика или попадают в файл вместе со списком «блокируем всех ИИ» из интернета.
Проверьте это место первым делом: оно занимает пять минут. Если хочется увидеть общий доступ роботов сайта в одном окне, кабинет ARTGK Code в блоке «Готовность сайта к нейросетям» отдельно показывает пункт «Сайт открыт для роботов нейросетей и Яндекса».
Как проверить robots.txt в Яндекс Вебмастере и Google Search Console?
В Вебмастере инструмент покажет, какие страницы разрешены поиску Яндекса. Разделы для других роботов он разбирает по общему стандарту: в справке сказано, что «остальные разделы проверяются в соответствии со стандартом», а проверку адресов инструмент делает для робота Яндекса (Яндекс). Пустит ли файл GPTBot, Вебмастер не скажет. Зато при подтверждённых правах в нём хранятся версии файла за 6 месяцев, до 100 штук, и по ним видно, в какой день файл поменяли.
В Search Console отчёт robots.txt показывает файлы для 20 главных хостов вашего сайта, дату последнего обхода и хранит версии за 30 дней (Search Console). Отчёт есть только у ресурса уровня домена: доменного ресурса или адреса без пути. Если у вас подтверждён ресурс с путём, отчёта в нём не будет. Инструмент «Проверка URL» тестирует живую страницу, но сообщение «URL is on Google» не гарантирует показ в результатах поиска (Search Console).
Для OpenAI, Anthropic и Perplexity есть только сам robots.txt, журналы вашего сервера и опубликованные компаниями списки IP-адресов. Ими пользуются в разделах про отказы и журналы ниже.
Что вы увидите в кабинете ARTGK Code по этой теме?
Откройте демо-кабинет: он работает без регистрации, на демонстрационных данных, изменения в нём не сохраняются. В карточке сайта выберите вкладку «Видимость в AI». В демо блок «Готовность сайта к нейросетям» показывает итог «8 в порядке · 1 доработать» и список пунктов. Для этой темы важны два пункта про доступ:
- «Сайт открыт для роботов нейросетей и Яндекса»;
- «Главная не скрыта от поиска».
Рядом есть пункты «Файл llms.txt для нейросетей» и «Карта сайта (sitemap.xml)». К доступу роботов они прямого отношения не имеют. Google для своих ИИ-ответов llms.txt не требует.
У проблемного пункта кабинет пишет «Что сделать». Кнопка «Заново» запускает проверку ещё раз, а вкладка «История» хранит ленту проверок с датами. Если правку должен сделать специалист, кнопка «Поручить доработки нам» отправляет задачу инженерам. По условиям кабинета оценка бесплатная, специалист пришлёт стоимость, а списания без вашего подтверждения не будет.
Чего кабинет не показывает: правила для каждого бота по отдельности, ответы вашего сервера под подписью GPTBot или PerplexityBot, журналы хостинга и IP-адреса роботов. Для этого служат разделы ниже и просьба хостингу или подрядчику. Кабинет отвечает на более простой вопрос: открыт ли сайт роботам нейросетей и Яндекса в целом и не скрыта ли от поиска главная. Проверить свой сайт можно бесплатно, текущие условия указаны на публичной странице.
Почему бот получает отказ, хотя robots.txt всё разрешает?
Google в справке про ИИ-функции перечисляет условия показа. Первое звучит так: «Ensuring that crawling is allowed in robots.txt, and by any CDN or hosting infrastructure». Перевод: убедитесь, что обход разрешён в robots.txt, а также в CDN и на хостинге (Google). OpenAI рекомендует разрешить OAI-SearchBot в robots.txt и пропускать запросы с опубликованных компанией диапазонов IP (OpenAI). Perplexity даёт ту же рекомендацию для PerplexityBot и отдельно пишет про защиту сайта: если вы используете межсетевой экран для веба (WAF), роботов Perplexity, возможно, придётся разрешить явно (Perplexity).
У Anthropic есть оговорка про капчи: боты компании не пытаются обходить CAPTCHA. Если на хостинге включена проверка «вы не робот», до страницы такой бот не дойдёт. Если защита блокирует адреса Anthropic, бот не прочтёт даже robots.txt: компания прямо предупреждает, что блок по IP мешает ей читать файл с вашими правилами (Anthropic).
Отдельный случай - сервисы защиты. Cloudflare 1 июля 2025 года объявил, что меняет настройку по умолчанию: ИИ-краулеры блокируются, если не платят авторам за контент (Cloudflare). Включена ли она у вас, видно только в панели Cloudflare. Модули безопасности и правила, оставшиеся от прошлого подрядчика, тоже стоит проверить.
Отдельная история, если ошибкой отвечает сам robots.txt. По спецификации Google, ответ 4xx (кроме 429) приравнивается к отсутствию файла, то есть ограничений нет. При ответе 5xx Google первые 12 часов совсем не обходит сайт, потом до 30 дней работает по последней удачной версии файла. Ещё Google читает файл только до 500 КиБ, у Яндекса предел 500 КБ (Google, Яндекс). Для Google всё, что дальше предела, не учитывается.
Типичный признак: браузеру сайт отдаёт код 200, а подпись бота получает 403 или 503. Что значат эти коды, расписано в статье «Сайт не открывается: что делать по шагам».
Как проверить ответ сервера под именем бота - и почему это ещё не доказательство?
Команда для подрядчика, вам достаточно сравнить два числа в ответе. Подпись OAI-SearchBot взята со страницы OpenAI:
curl -s -o /dev/null -w "%{http_code} %{size_download}\n" \
  -A "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot" \
  https://ваш-сайт.ru/
Команда печатает код ответа и размер страницы в байтах. Выполните её, затем повторите команду, заменив текст в кавычках после -A на подпись обычного браузера, например Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36. Сравните два результата. Один и тот же код и близкий размер - хороший знак. Код 403 или 503 при обычном 200, или заметно меньший размер - повод идти к хостингу. OpenAI предупреждает, что номер версии в подписи может меняться, поэтому в журналах ищите по имени бота без версии.
Совпадение ещё не доказательство. Google пишет: «The HTTP user agent string can be spoofed» (подпись робота можно подделать, Google). Защита вправе проверять и IP, а ваш запрос идёт не из диапазонов OpenAI. Списки адресов компании публикуют сами: openai.com/searchbot.json у OAI-SearchBot (OpenAI) и perplexity.ai/perplexitybot.json у PerplexityBot (Perplexity). Ещё две команды для проверки видимости текста в HTML разобраны в статье «Почему ChatGPT и Алиса не советуют вашу компанию».
Что покажут журналы сервера и как попросить их у хостинга?
Готовая просьба, которую можно отправить хостингу или подрядчику:
Как читать ответ. Коды 200 значат, что бот получил страницу. Коды 403, 429 и 503 значат отказ. Если нужного бота в журнале нет совсем, он на сайт не заходил. Почему, по одному журналу не понять: причиной может быть и защита, и то, что бот просто не обращался. Google-Extended в журнале не появится: отдельной подписи у него нет. YandexAdditional, по справке Яндекса, не делает запросов для индексирования. Если их нет в журнале, это нормально. ChatGPT-User, Claude-User и Perplexity-User приходят только тогда, когда пользователь нейросети задал вопрос и ей понадобилась ваша страница, поэтому их отсутствие тоже ничего не значит.
Если сайт стоит за CDN вроде Cloudflare, запросы, которые отсекла защита CDN, до хостинга не доходят и в его журнал не попадут. Их смотрят в панели CDN.
Чтобы убедиться, что запрос шёл действительно от Яндекса, делают обратный запрос по DNS: имена всех роботов Яндекса оканчиваются на yandex.ru, yandex.net или yandex.com (Яндекс). Затем прямой запрос по этому имени должен вернуть тот же IP-адрес. Для Googlebot допустимы домены googlebot.com, google.com и googleusercontent.com (Google). Если сайт стоит за Cloudflare, в разделе AI Crawl Control видно, какие ИИ-сервисы получают доступ к материалам, и можно задавать правила для отдельных краулеров (Cloudflare). О том, как узнавать о падении сайта раньше клиентов, написано в статье «Мониторинг доступности сайта».
Видит ли ИИ-бот текст, если страницу собирает JavaScript?
Google пишет, что Googlebot отрисовывает страницу в безголовом Chromium и выполняет JavaScript (Google). У Яндекса есть YandexRenderResourcesBot, он загружает ресурсы для рендеринга страниц с JavaScript. Про роботов нейросетей официальных заявлений нет. Единственный замер, который удалось найти, сделала Vercel в декабре 2024 года: «none of the major AI crawlers currently render JavaScript» (ни один из крупных ИИ-краулеров сейчас не выполняет JavaScript, Vercel). За месяц до публикации замера в сети Vercel GPTBot сделал 569 млн запросов, Claude 370 млн, PerplexityBot 24,4 млн, а Googlebot 4,5 млрд. Данным почти два года, и с тех пор ситуация могла измениться.
Практический вывод: цены, адрес, телефон и описание услуг должны лежать в HTML страницы, а не подгружаться скриптом после открытия. Как это проверить командой за минуту, показано в статье «Почему ChatGPT и Алиса не советуют вашу компанию».
Сколько ждать, пока нейросети заметят исправление?
| Сервис | Срок по документации | Источник |
|---|---|---|
| OpenAI (поиск) | около 24 часов после обновления robots.txt | OpenAI |
| Perplexity | до 24 часов | Perplexity |
| Яндекс (правило для ответов Алисы) | от 2 до 14 дней | Вебмастер |
| Google (кэш robots.txt) | до 24 часов | |
| Google (переобход страниц) | от нескольких дней до нескольких месяцев |
Google при этом оговаривает: «Indexing and serving isn't guaranteed» (индексирование и показ не гарантируются). Если robots.txt нужно перечитать срочно, в отчёте robots.txt в Search Console есть кнопка повторного обхода. Если после исправления сайт всё равно не появляется в ответах, это не значит, что доступ закрыт: нейросеть может просто не выбрать вашу страницу.
Какие ошибки с ИИ-ботами в robots.txt встречаются чаще всего?
- Список «блокируем всех ИИ» из интернета. Вместе с обучением выпадают OAI-SearchBot, Claude-SearchBot и PerplexityBot, то есть поиск нейросетей. Сверяйте имена с таблицей выше.
- Несуществующие боты. Названия «YandexAI» и «anthropic-ai» ходят по статьям, но в официальном списке роботов Яндекса и на странице Anthropic их нет. У Anthropic сейчас три бота: ClaudeBot, Claude-User и Claude-SearchBot.
- Google-Extended ради ухода из AI Overviews. Он на показ в Поиске не влияет. Управление идёт через роботов и сниппеты Google: чтобы ограничить показ в Поиске, Google советует директивы nosnippet, data-nosnippet, max-snippet или noindex.
- Попытка закрыть ChatGPT-User и Perplexity-User через robots.txt. OpenAI и Perplexity прямо пишут, что правила могут не применяться.
- Блокировка по IP вместо robots.txt. Anthropic предупреждает, что так бот не прочтёт файл и запрет может работать некорректно.
- Запрет в robots.txt как защита контента. Стандарт RFC 9309 2022 года говорит: «These rules are not a form of access authorization» (эти правила не являются способом ограничить доступ, RFC 9309). Закрытое надо прятать за паролем.
Cloudflare 4 августа 2025 года заявил, что Perplexity обходит запреты через незадекларированных краулеров (Cloudflare). Это позиция одной стороны: Perplexity в своей документации утверждает, что PerplexityBot правила уважает. Если запрет для вас важен, держите ограничение ещё и на уровне хостинга.
Про остальные технические ошибки, которые видны за пять минут, читайте в статье «10 SEO-ошибок, которые видны за 5 минут бесплатной проверки».
Источники
- Боты OpenAI, документация: developers.openai.com
- ИИ-функции Google и ваш сайт: developers.google.com
- Обычные краулеры Google, включая Google-Extended: developers.google.com
- Спецификация robots.txt, Google: developers.google.com
- Проверка запросов Google: developers.google.com
- JavaScript и поиск Google: developers.google.com
- Отчёт robots.txt в Search Console: support.google.com
- Проверка URL в Search Console: support.google.com
- Боты Anthropic и как их ограничить: support.claude.com
- Краулеры Perplexity: docs.perplexity.ai
- Роботы Яндекса: yandex.ru
- Как робот Яндекса читает User-agent: yandex.ru
- Анализ robots.txt, Яндекс Вебмастер: yandex.ru
- Как работает Нейро и как его ограничить: webmaster.yandex.ru
- RFC 9309, протокол исключений для роботов: rfc-editor.org
- Веб-поиск и Microsoft Copilot: learn.microsoft.com
- Cloudflare о блокировке ИИ-краулеров по умолчанию: blog.cloudflare.com
- Cloudflare AI Crawl Control: developers.cloudflare.com
- Замер Vercel про ИИ-краулеры: vercel.com
Проверить, открыт ли ваш сайт роботам нейросетей и Яндекса, можно в бесплатной проверке кабинета ARTGK Code: для начала нужен только email. Если найденное нужно исправить, задачу можно поручить инженерам прямо из кабинета, оценка бесплатная.